 Ediciones ENI Editorial | líder en informática

Arquitecturas avanzadas y buenas prácticas
Introducción
La arquitectura avanzada en AWS no se limita a apilar servicios o multiplicar diagramas. Consiste en diseñar sistemas capaces de resistir fallos, absorber picos de carga importantes, garantizar la coherencia de los datos, recuperarse rápidamente y seguir siendo fáciles de gestionar a pesar de su complejidad natural.
En este capítulo, abordaremos los enfoques fundamentales de una arquitectura robusta: elasticidad, multi-AZ y multirregión, construcción de arquitecturas basadas en eventos, aislamiento de microservicios y control de costes.
Cada subcapítulo sigue una progresión didáctica inspirada en los capítulos anteriores: conceptos → ejemplos → buenas prácticas → errores frecuentes.
Diseñar una infraestructura escalable y robusta
Diseñar una arquitectura escalable y robusta en AWS requiere mucho más que seleccionar los "servicios adecuados". Se trata de un proceso de ingeniería completo que se basa tanto en una comprensión profunda de los mecanismos internos de la nube, como en los principios de la arquitectura distribuida y en una disciplina operativa constante.
En las organizaciones modernas, esta solidez ya no es un lujo: se ha convertido en un requisito imprescindible para cualquier sistema expuesto a fuertes variaciones de carga, a elevadas exigencias de disponibilidad o a un rápido crecimiento del tráfico.
AWS ofrece un conjunto excepcionalmente amplio de servicios diseñados para absorber las interrupciones, redimensionarse automáticamente y mantener la disponibilidad incluso en situaciones extremas. Pero aún hay que saber cómo organizarlos y orquestarlos. El objetivo de esta sección es exponer de forma progresiva los fundamentos de una arquitectura verdaderamente resiliente, explicando no solo "qué utilizar", sino sobre todo "por qué" y "en qué situaciones".
Principio: diseñar pensando en el fallo
La idea más importante que hay que aceptar al diseñar una arquitectura en la nube es también la más contraria a la intuición: todo acaba fallando.
Los discos, los servidores, los enlaces de red, las fuentes de alimentación, los sistemas operativos e incluso las regiones de la nube pueden sufrir fallos parciales o totales. Por lo tanto, la cuestión no es si se producirá un fallo, sino si la aplicación será capaz de seguir funcionando cuando este se produzca.
Este principio, conocido como "Design for Failure", es el que estructura toda la filosofía de AWS. En la práctica, obliga a replantearse la arquitectura como un conjunto de componentes que pueden desaparecer en cualquier momento sin comprometer la integridad del sistema. Esto implica, por ejemplo, evitar las dependencias únicas, duplicar los recursos esenciales, separar estrictamente la lógica de la aplicación del estado, o incluso automatizar los mecanismos de conmutación y recuperación.
En la industria del lujo, un sector en el que las ventas en línea deben permanecer disponibles en cualquier época del año, parece que los entornos más resilientes no son aquellos que cuentan con el mayor número de servidores, sino aquellos que aplican este principio con rigor: ninguna suposición implícita sobre la disponibilidad...
La elasticidad: adaptar la capacidad en función de la carga
Un sistema escalable es aquel que se ajusta automáticamente a la demanda. Esta capacidad para absorber picos repentinos de tráfico, sin intervención humana, es uno de los grandes puntos fuertes de la nube frente a las infraestructuras tradicionales.
Para ello, AWS ofrece un mecanismo que se ha convertido en imprescindible: el Auto Scaling Group. Las instancias EC2 ya no se crean ni se eliminan manualmente; son unas reglas basadas en métricas reales (CPU, latencia del Load Balancer, tamaño de las colas, métricas personalizadas) las que determinan de forma continua el número necesario de instancias. En algunos entornos, esta adaptación se puede producir varias decenas de veces por hora.
Durante el lanzamiento de una colección de una marca de lujo, una plataforma pasó, en tan solo tres minutos, de unas diez instancias a más de ochenta sin ninguna intervención humana. Esta capacidad de absorción es precisamente lo que permite evitar interrupciones del servicio durante eventos de marketing, campañas publicitarias o picos estacionales.
Pero la elasticidad no se limita a las instancias de EC2. Los servicios sin servidor, como AWS Lambda o Fargate, ofrecen una escalabilidad casi instantánea, a veces sin límite teórico, aunque las cuotas de concurrencia y los mecanismos de throttling imponen...
Distribución del tráfico: la importancia del Load Balancer
Para que un sistema sea realmente robusto, el aumento de la carga debe ir acompañado de un mecanismo inteligente de distribución del tráfico. Esa es la función del ALB (Application Load Balancer), un punto de entrada esencial en la mayoría de las arquitecturas web modernas.
El equilibrador de carga no se limita a «equilibrar» el tráfico: evalúa el estado de las instancias, elimina automáticamente del grupo aquellas que ya no responden, aplica reglas avanzadas de enrutamiento, gestiona los tiempos de espera tanto del lado del cliente como del lado del destino, y proporciona un conjunto de métricas indispensables para comprender el comportamiento de la aplicación.
En una auditoría que realicé en el sector del comercio electrónico, llegué a diagnosticar errores 502 recurrentes causados no por la aplicación, sino por un tiempo de espera mal configurado en el equilibrador de carga. Este tipo de problema ilustra bien la importancia de una configuración minuciosa: un sistema perfectamente dimensionado se puede volver inestable si la capa de equilibrio de carga no está ajustada correctamente.

Multi-AZ: aprovechar la estructura física de AWS
Una infraestructura robusta utiliza sistemáticamente varias zonas de disponibilidad (AZ).
AWS ha diseñado estas zonas como centros de datos físicamente separados, conectados mediante enlaces de muy baja latencia, pero capaces de soportar el fallo de un edificio entero sin interrumpir el funcionamiento de los demás.
Desplegar instancias EC2, contenedores ECS/EKS, bases de datos RDS o servicios de apoyo en varias zonas no requiere ninguna modificación de software: es una configuración intrínseca de AWS.
Sin embargo, en la práctica, muchas interrupciones se deben a sistemas desplegados en una única zona, a menudo por costumbre, a veces por desconocimiento y otras veces por motivos económicos, una decisión de la que casi siempre se arrepienten cuando se produce una interrupción real.
Los servicios de bases de datos ilustran especialmente bien el valor de Multi-AZ. Con RDS Multi-AZ, la replicación sincrónica garantiza que un fallo en la instancia principal provoque una conmutación automática a la instancia de respaldo, normalmente en menos de un minuto. Con Aurora, esta resiliencia es aún mayor: seis copias de los datos distribuidas en tres zonas, con capacidad para conmutar el escritor o los lectores en cuestión de segundos.

Almacenamiento y contenido estático: externalizar lo que no debe fallar
En las arquitecturas modernas, no se debe almacenar nada en las propias instancias. Los archivos de los usuarios, las imágenes de productos, los documentos, los registros archivados o los archivos multimedia se deben externalizar a un servicio diseñado para durar y resistir: Amazon S3.
S3 ofrece una durabilidad prácticamente perfecta, pero sobre todo una disponibilidad muy elevada, ya que los objetos se replican automáticamente dentro de la región. En combinación con CloudFront, se convierte en una plataforma de distribución global, capaz de servir contenidos en cualquier parte del mundo con una latencia mínima.
En un proyecto de edición digital, la implementación de una replicación interregional de S3 (CRR) permitió garantizar la continuidad del servicio incluso ante un fallo regional total, un escenario poco frecuente, pero no imposible.

Aplicaciones sin estado: la condición indispensable para la escalabilidad
Una aplicación escalable debe ser stateless: una instancia de EC2 debe poder desaparecer en cualquier momento sin que ello suponga la pérdida de ningún usuario ni de ningún proceso en curso.
Esto implica trasladar fuera de la instancia:
-
las sesiones (ElastiCache Redis),
-
los archivos temporales (S3),
-
las colas (SQS),
-
las cachés compartidas (DynamoDB, que no es una caché en sentido estricto, pero puede hacer las veces de ella en algunos casos).
Esta arquitectura permite eliminar y volver a crear las instancias a voluntad, sin riesgo funcional.
En el sector minorista, se observó una reducción significativa de la tasa de errores HTTP 500 tras la migración de las sesiones locales a Redis, lo que ilustra hasta qué punto la statelessness constituye una condición fundamental para la resiliencia operativa.

Observar para comprender: la importancia de la observabilidad
Una arquitectura robusta es también una arquitectura observable. Las métricas, los logs y las trazas deben permitir comprender rápidamente lo que ocurre en el sistema, con el fin de detectar anomalías antes de que afecten a los usuarios.
Para ello, AWS ofrece un conjunto coherente de servicios:
-
CloudWatch Metrics para supervisar el estado del sistema.
-
CloudWatch Logs para centralizar y estructurar los registros.
-
AWS X-Ray para realizar un seguimiento de las llamadas entre microservicios.
-
OpenSearch para buscar, correlacionar y analizar los registros.
-
Grafana para crear paneles de control claros.
-
Synthetics Canaries para simular recorridos reales de los usuarios.
Durante un proyecto en un entorno de streaming de vídeo, la introducción de X-Ray permitió reducir el tiempo medio de resolución de incidencias (MTTR) de 45 minutos a menos de 10 minutos, simplemente porque por fin era posible visualizar el recorrido de una solicitud a través de todos los microservicios.

Automatizar y codificar: el papel de la IaC
Por último, ninguna arquitectura se puede considerar robusta si la infraestructura se gestiona manualmente.
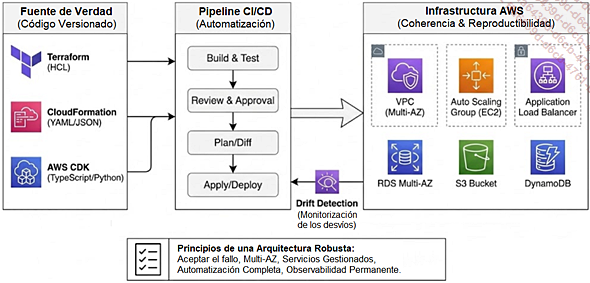
La automatización mediante Infrastructure as Code (IaC) garantiza la coherencia, la reproducibilidad y la rapidez de implementación. Elimina las desviaciones, reduce los errores humanos y permite reversiones fiables.
Ya sea con Terraform, CloudFormation o el CDK, la IaC se convierte en una disciplina fundamental: los entornos se versionan, los cambios se revisan, se prueban y se implementan mediante un pipeline y la deriva (drift) se supervisa y se corrige.
Diseñar una infraestructura escalable y robusta en AWS no es una cuestión de herramientas, sino de principios: aceptar el error, trabajar en Multi-AZ, delegar el estado a servicios gestionados, automatizar todo el ciclo de vida, observar el sistema de forma continua y apoyarse en plataformas diseñadas para durar. Es esta arquitectura, viva, adaptable y autorregulada, la que permite a una organización hacer frente al crecimiento, a los imprevistos y a los eventos extremos, sin dejar de ofrecer un servicio fiable a sus usuarios.
Las arquitecturas avanzadas en AWS no están reservadas a las grandes plataformas globales ni a los equipos con recursos ilimitados. Se basan, ante todo, en una serie de principios estructurales que se pueden aplicar de forma progresiva, independientemente del contexto empresarial o del tamaño...